隨著 AI 使用人數增加,管理單位一定遇到以下幾個問題:哪個部門花了多少錢?誰手上還留著能呼叫模型的憑證?系統當更換供應商時,如何在毫無延遲下重新串接?有很多 MCP server 以及 Skills 散落在不同部門之間,我要怎麼整合他們?這些看似瑣碎的小問題,最終會變成管理層必須承擔的大風險,站在技術的角度是不是有種工具可以協助從根本解決問題呢?LiteLLM 就是以上種種問題的解答。
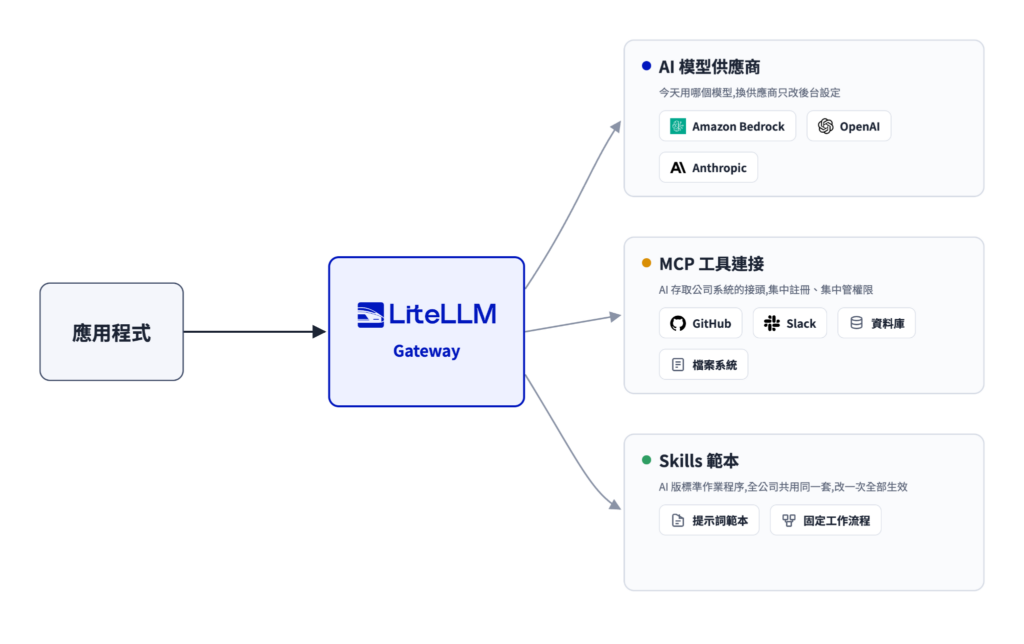
LiteLLM 提供的 AI Gateway,就是透過從技術角度解決治理議題。它的優點在於與各家模型供應商之間架起統一的呼叫介面,原生支援 AWS Bedrock,也能視需求接上其他主流供應商,讓企業不必為了換模型重寫程式碼,也不必在規模化的同時放棄對金鑰、成本與資料的掌控。容器化的服務可以快速地架在 AWS 之上,借用既有的網路安全與基礎設施服務,不必從零開始蓋一套治理機制。
LiteLLM 是什麼:一句話講清楚
LiteLLM 可以理解成「AI 使用的收費站與檢查哨」。在導入之前,公司對外串接 Bedrock、OpenAI 等供應商,往往是各個團隊各自為政,各自管理自己的金鑰與呼叫方式。導入之後,所有 AI 請求改由這一層統一接收,再依後台設定決定轉送到哪個供應商、哪個模型。重點不在於它讓 AI 變得更聰明,而在於所有的用量、花費與內容,都會在這一關留下紀錄,也都能在這一關被攔截下來。
為什麼需要使用 LiteLLM?
如果團隊已經在用 Bedrock 呼叫 Claude,但當團隊數量增加、金鑰分散管理、需要統一追蹤花費,或需要在請求送出前攔截敏感資料(如信用卡號、API 金鑰)時,單純的 Bedrock IAM 權限已經不足以應付這些治理需求。
主要優點:
- 統一的 API 介面,前端串接一次,後台可切換 Bedrock、OpenAI、Anthropic 等不同供應商而不須改動應用程式程式碼
- 透過 Virtual Key 集中發放與撤銷,不需要每個人各自持有一組長期 API Key
- 依 Key 或 Team 設定花費上限(Budget)與速率限制(RPM/TPM),超過即擋下請求
- 內建 Guardrails,可在請求送出前偵測並遮蔽(Mask)或直接擋下(Block)信用卡號、API 金鑰等敏感內容
- 開源版本(self-hosted)即可使用上述大部分功能,不需要一開始就採購 Enterprise 授權
- 完全架設在自己的 infrastructure 內,資料與金鑰不經過第三方
對管理層來說,真正值得關心的三件事
對管理層而言,真正該關心的並不是這套工具技術上怎麼運作,而是以下三件事。
1. 錢花在哪裡、誰負責、看得到
每個團隊或應用程式領到的不是公司共用的一組密碼,而是各自專屬、可以單獨關閉的使用憑證,花費也會分別歸戶到各自名下。一旦某個專案的月用量超過預算,系統會直接停止後續請求,而不必等到月底帳單出爐才驚覺超支。員工離職或專案結束時,只需關閉對應的憑證即可,不會影響其他人正在使用的部分,不會再出現憑證無人停用、或者持續被呼叫的狀況。
LiteLLM 可以依自訂的時間區間查看整體用量,包括這段期間一共花了多少錢、送出了多少次 request、其中有多少成功多少失敗,以及總共用掉多少 token,不必等外部帳單寄來才知道。這些數字即時更新,也能看出目前的用量是不是異常,方便在問題變大之前先發現。同時也能依模型拆解用量,看出是哪一個模型被呼叫得最多、花費最高。

2. 內容如何做到統一的審查?
送進模型的內容與模型回覆的內容,都可以統一先經過一層檢查,偵測信用卡號、個資、內部機密等敏感資訊,一旦發現便加以遮蔽或直接擋下,而不是仰賴員工自律提醒自己小心。這一關同時也能攔截惡意誘導模型洩漏資訊的手法。對於必須符合資安規範或客戶保密條款的公司而言,這正是把「提醒大家小心」落實成「系統真的會擋下來」的關鍵差異。當客服團隊貼上客戶資料的狀況,在這一關就會被攔下,而不必等到稽核才發現。
LiteLLM 能監控每一條 Guardrails 規則的實際運作狀況,包括這段期間總共檢查了多少次請求、擋下了多少次、整體通過率多少。也能細分到個別規則,看出是哪一條規則觸發、觸發了幾次、失敗率多少,方便之後追蹤要不要調整規則。每一筆請求也能點進去查看詳細紀錄,包含觸發的時間點與其他相關資訊,方便事後稽核或回溯特定事件
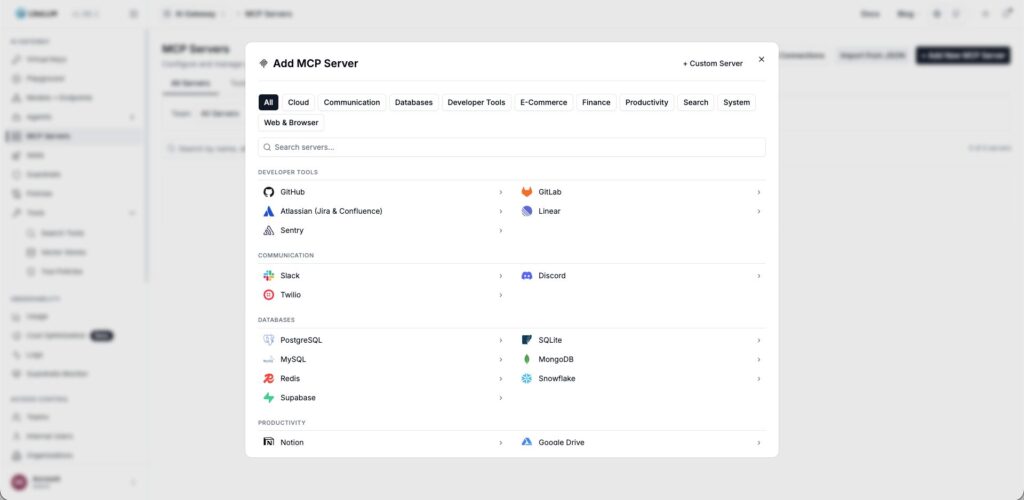
同樣的邏輯也套用在 AI 碰得到的其他東西上。AI 用來存取公司系統的 MCP 連接,還有公司內部常用的提示詞範本與固定工作流程(Skills),一樣透過同一個 Gateway 集中管理,誰能用哪些工具、哪些範本,都在後台統一設定,權限歸屬一目了然,不再是分散各處、沒人說得清楚是誰能碰的狀態。
3. 快速且輕鬆地切換模型
不同時期不同模型都會有他的優勢,今天使用的是 Bedrock 上的 Claude,如果哪天有需要更動至其他模型時的只需要到後台修改設定即可,前端應用程式不必重寫任何一行程式碼。對經營層而言,這代表 AI 這條業務線的延續性。
附錄:架構怎麼運作的
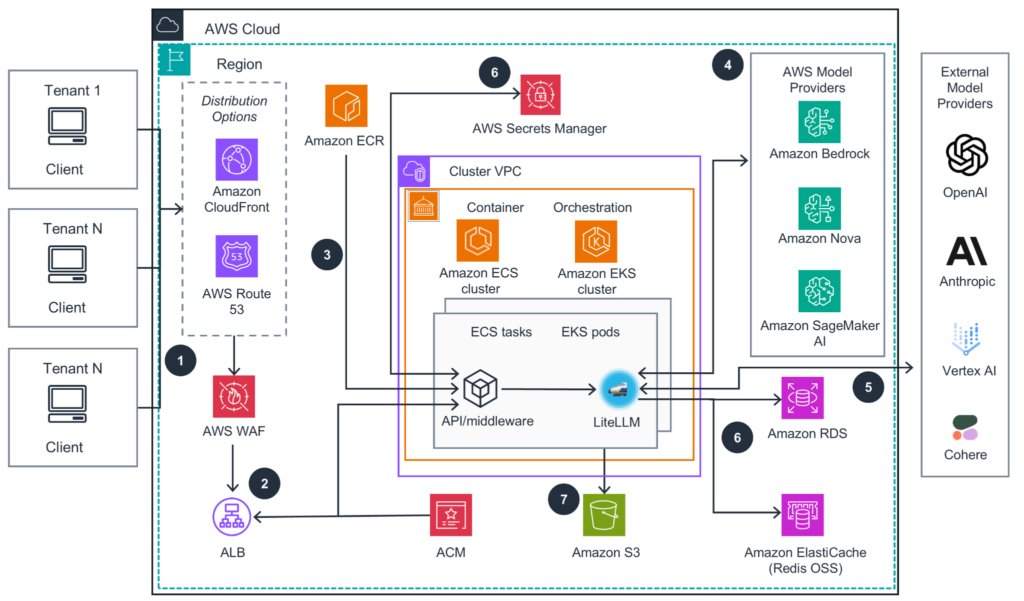
LiteLLM 可以搭配 AWS 的服務進一步提升安全以及便利性,相關配置可以參考上方架構圖,以下將詳細說明功能及用途:
- 不同部門的使用者,請求時會先透過 AWS 的邊緣服務 Amazon CloudFront 進行訪問。
- 請求經過 AWS WAF 擋下常見的網路攻擊,再交給 Application Load Balancer(ALB)分流,ALB 的加密憑證由 AWS Certificate Manager 簽發與管理。
- ALB 把請求送進公司專屬的網路環境(VPC),其中含有 LiteLLM 與一層 API/middleware,這些服務用容器方式部署,可以選擇用 Amazon ECS 或 Amazon EKS 管理,容器的映像檔則存放在 Amazon ECR。
- LiteLLM 依照後台設定,把請求轉送到實際要呼叫的模型,可以是 AWS 內建的 Amazon Bedrock、Amazon Nova、Amazon SageMaker AI,也可以是外部的 OpenAI、Anthropic、Vertex AI、Cohere 等供應商。
- 遇到重複或相似的請求,會先查詢 Amazon ElastiCache(Redis)裡暫存的結果,減少不必要的模型呼叫,同時節省費用與等待時間。
- 呼叫各家供應商所需要的金鑰,集中保管在 AWS Secrets Manager,不會寫死在程式碼裡,使用紀錄、花費與團隊設定等需要長期保存的資料,則存放在 Amazon RDS 資料庫。
- 用量較大的日誌或檔案類資料,存放在 Amazon S3。
整張圖的重點在於,員工或應用程式從頭到尾只對接同一個入口,背後實際呼叫哪個供應商、金鑰存在哪裡、花費記在哪裡,都在公司自己的網路環境內被集中管理,不會散落在個別工程師的電腦或程式碼裡。